Ein Handelsunternehmen wollte im vergangenen Jahr eine Auswertung bauen, die zeigt, welche Kunden in den letzten zwölf Monaten weniger gekauft haben als davor. Eine vernünftige Idee, technisch keine große Sache.
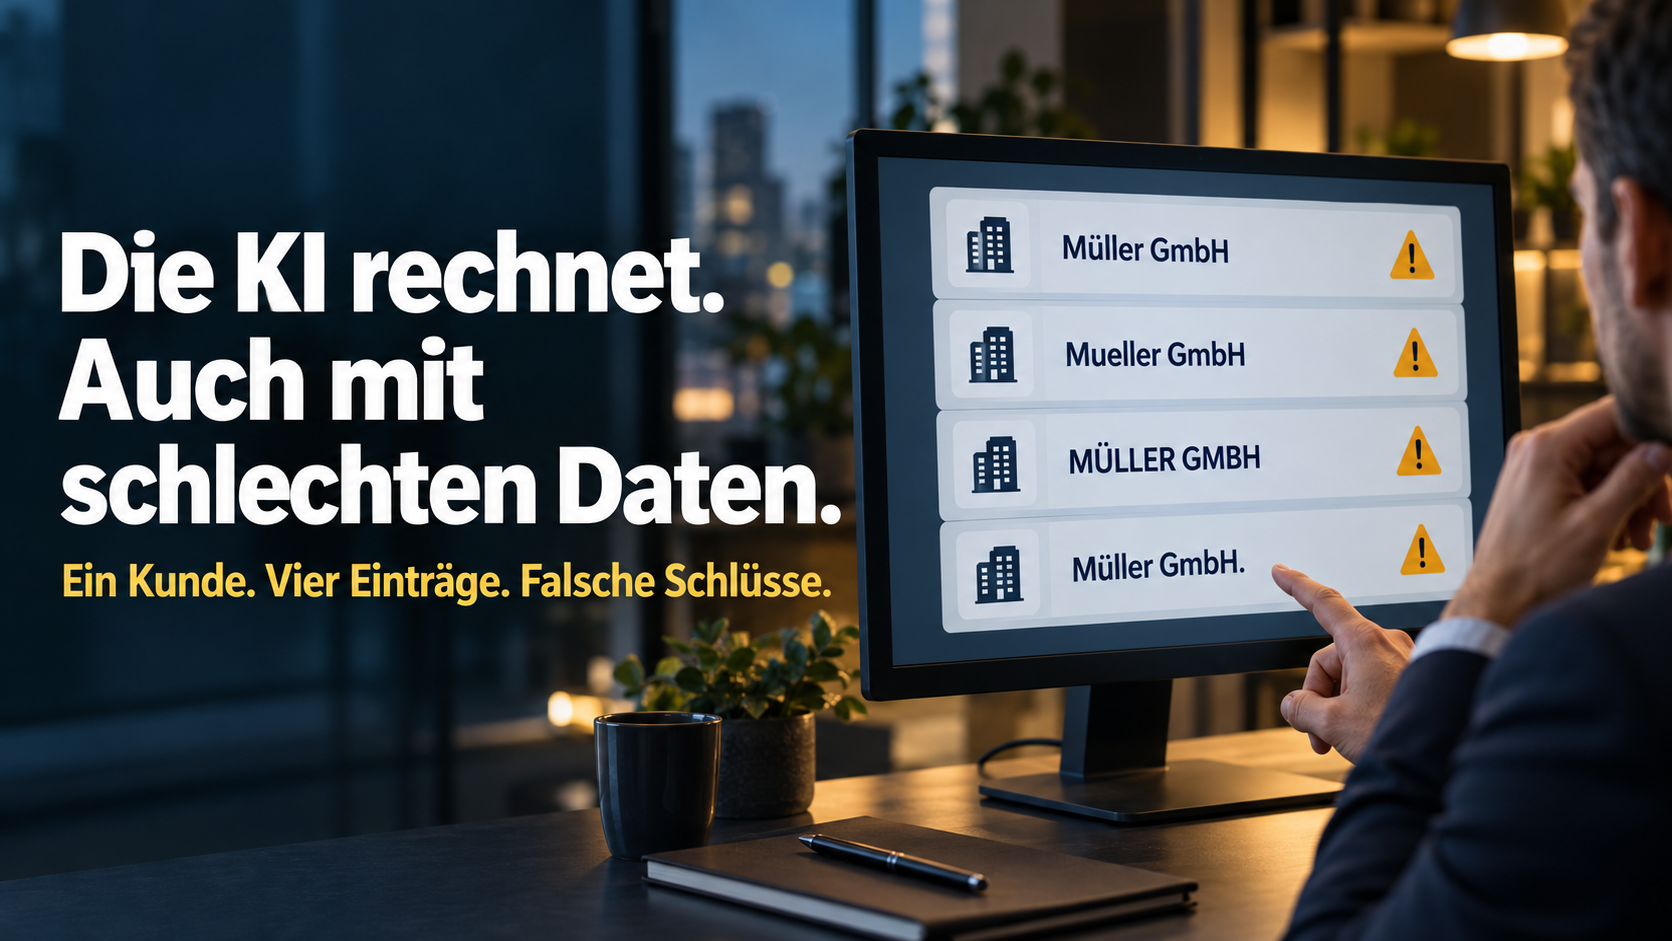
Das Ergebnis war unbrauchbar. Nicht weil die Auswertung falsch gerechnet hätte, sondern weil im System für einen einzigen Kunden vier Datensätze existierten. Einer aus dem alten Warenwirtschaftssystem, einer aus einer Messe-Liste, zwei aus Bestellungen, bei denen jemand den Firmennamen unterschiedlich geschrieben hatte. Die Umsätze verteilten sich auf alle vier. Jeder einzelne sah nach einem Rückgang aus.
Der Geschäftsführer sagte danach den Satz, den ich häufig höre: "Dann funktioniert die KI bei uns wohl nicht."
Die KI hat funktioniert. Sie hat nur genau das ausgerechnet, was in den Daten stand.
Warum das so oft übersehen wird
In Projektplänen steht meistens: Anforderungen klären, Tool auswählen, anbinden, testen, ausrollen. Die Datenqualität taucht als eigener Punkt selten auf, weil alle Beteiligten davon ausgehen, dass die Daten in Ordnung sind. Sie werden ja täglich benutzt.
Das ist der Denkfehler. Ein Mensch, der eine Bestellung erfasst, gleicht Unstimmigkeiten unbewusst aus. Er sieht "Müller GmbH" und "Mueller GmbH" und weiß, dass das dieselbe Firma ist. Er sieht ein Lieferdatum im Feld für das Bestelldatum und korrigiert es im Kopf. Die Datenbank hat diese Fähigkeit nicht.
Solange nur Menschen mit den Daten arbeiten, bleiben die Fehler unsichtbar. Sobald eine Automatisierung darauf zugreift, werden sie zum Ergebnis.
Die vier Probleme, die ich fast immer finde
Dubletten. Derselbe Kunde, Lieferant oder Artikel mehrfach angelegt. Entsteht durch Systemwechsel, Importe und fehlende Pflichtfelder bei der Neuanlage.
Freitextfelder statt Auswahllisten. Wenn die Branche des Kunden ein freies Textfeld ist, finden Sie darin irgendwann 40 Schreibweisen für "Maschinenbau". Auswerten lässt sich das nicht mehr, ohne vorher aufzuräumen.
Leere Pflichtfelder. Felder, die eigentlich gefüllt sein müssten, sind es bei den Altdatensätzen nicht. Die Automatisierung bekommt dann entweder nichts oder, schlimmer, einen Standardwert, der falsch ist.
Wissen, das nirgends steht. Das ist der Fall, der am längsten unbemerkt bleibt. Der Innendienst weiß, dass bei Kunde A immer ein anderer Ansprechpartner zeichnet und bei Kunde B nie vor Dienstag geliefert wird. Es steht in keinem Feld. Es steht in Köpfen und in E-Mail-Verläufen. Wer den Ablauf automatisiert, ohne dieses Wissen zu erfassen, baut eine Lösung, die in genau den Fällen versagt, in denen es darauf ankommt.
Der Zwei-Tage-Test, bevor Sie irgendetwas kaufen
Ich mache das mittlerweile in jedem Vorgespräch und es kostet kaum Zeit.
Exportieren Sie die Tabelle, die für Ihr geplantes Projekt am wichtigsten ist. Kundenstamm, Artikelstamm, Lieferantenstamm, je nachdem. Dann zählen Sie vier Dinge:
- Wie viele Datensätze haben denselben oder einen sehr ähnlichen Namen? Eine Sortierung nach Name und ein Blick über die Liste reicht für den ersten Eindruck.
- Wie viele Datensätze wurden in den letzten 24 Monaten nicht angefasst? Das sind Ihre Karteileichen.
- Wie viele Felder, die Sie für die Auswertung brauchen, sind leer?
- Nehmen Sie 20 zufällige Datensätze und lassen Sie die Fachabteilung prüfen, ob die Angaben stimmen. Nicht ob sie gefüllt sind. Ob sie stimmen.
Wenn bei Punkt vier mehr als drei von 20 danebenliegen, haben Sie kein KI-Projekt vor sich, sondern zuerst ein Datenprojekt.
Das ist keine schlechte Nachricht. Es ist eine sehr gute, wenn Sie es vor dem Projekt erfahren und nicht mittendrin. Die Aufräumarbeit kostet je nach Datenmenge ein paar Tage bis ein paar Wochen. Die Entdeckung im laufenden Projekt kostet die Glaubwürdigkeit des ganzen Vorhabens.
Aufräumen, ohne alles aufzuräumen
Die häufigste Reaktion an diesem Punkt ist der Wunsch nach einem großen Datenqualitätsprojekt. Davon rate ich ab. Solche Vorhaben dauern lange, binden Leute und liefern erst am Ende etwas.
Besser ist der umgekehrte Weg: Räumen Sie nur den Ausschnitt auf, den Ihr erstes Projekt braucht. Wenn die Auswertung 200 aktive Kunden betrifft, müssen Sie nicht 8.000 Datensätze bereinigen. Sie müssen 200 bereinigen.
Zwei Regeln haben sich dabei bewährt. Erstens: Jedes Feld bekommt einen Verantwortlichen, der es pflegt. Ein Feld ohne Zuständigkeit verfällt wieder. Zweitens: Neue Datensätze werden ab sofort mit Pflichtfeldern und Auswahllisten angelegt, sonst füllen Sie parallel zum Aufräumen die nächste Baustelle.
Wie man von gewachsenen Tabellen zu einer Struktur kommt, mit der sich arbeiten lässt, habe ich am Beispiel Excel in diesem Beitrag beschrieben. Und warum Projekte auch aus anderen Gründen hängenbleiben, steht unter KI-Projekte scheitern im Mittelstand.
Was Sie davon haben, auch ohne KI
Ein Nebeneffekt, den ich unterschätzt hatte: Die Bestandsaufnahme der Daten führt fast immer zu Erkenntnissen, die nichts mit dem geplanten Projekt zu tun haben. Bei dem Handelsunternehmen kam heraus, dass zwei Preislisten im Umlauf waren und der Vertrieb seit Monaten mit der falschen arbeitete. Das hatte niemand gemerkt, weil niemand die Daten je zusammen angeschaut hatte.
Das Projekt lief am Ende. Drei Wochen später als geplant, weil vorher 1.100 Kundendatensätze auf 780 zusammengeführt wurden. Die Auswertung, die daraus entstand, wird heute jeden Montag gelesen.
Wenn Sie wissen wollen, wie belastbar Ihre Datenbasis ist, ist das ein guter erster Schritt, bevor Sie über Werkzeuge reden. Wie ich Firmenwissen strukturiere und auffindbar mache, steht unter Wissensmanagement.
KI Bild generiert von Gemini